
用于Microsoft Fabric Lakehouse的DuckDB查询API
一种FastAPI服务,使用DuckDB为Microsoft Fabric Lakehouse表提供只读SQL查询接口。包括一个用于交互式自然语言驱动查询的MCP(模型上下文协议)服务器(与GitHub Copilot一起使用)。该项目旨在针对Fabric lakehouse表进行只读分析,并包括一个可选 data_generator.py 帮助在单独的Microsoft Fabric环境中填充测试数据。
—
- 示例分析查询:本年度月度前5名购买产品。
下面的图片 doc/img/ 是示例MCP会话屏幕截图(发现、采样、聚合),用于说明MCP通过结构集成连接到DuckDB时的预期行为。
特性
- 只读查询 -强制SQL验证以防止写入操作
- 快速执行 -利用DuckDB的高性能分析引擎
- 织物集成 -通过OneLake直接访问Microsoft Fabric Lakehouse表
- 灵活的身份验证 -支持服务主体、Azure CLI和交互式浏览器身份验证
- 三角洲湖支持 -直接从Fabric Lakehouse读取Delta表
- Docker就绪 -集装箱化部署
- API完整文档 -自动生成的OpenAPI/Swagger文档
项目结构
.
├── app/
│   ├── __init__.py
│   ├── main.py              # FastAPI app entrypoint
│   ├── config.py            # Configuration management
│   ├── db.py                # DuckDB connection & table registration
│   ├── models.py            # Pydantic request/response models
│   ├── fabric_client.py     # Fabric authentication & lakehouse access
│   ├── api/
│   │   ├── routes_health.py # Health check endpoint
│   │   └── routes_query.py  # Query execution endpoint
│   └── services/
│       └── query_service.py # Query validation & execution logic
├── tests/
│   ├── test_query_endpoint.py
│   └── test_validation.py
├── .env.example             # Environment configuration template
├── requirements.txt
├── Dockerfile
├── docker-compose.yml
└── README.md
快速开始
先决条件
- Python 3.11+
- 带Lakehouse的Microsoft Fabric工作区
- Azure凭据(服务主体、Azure CLI或基于浏览器的身份验证)
安装
- 克隆存储库
- 复制
.env.example到.env并配置:
cp .env.example .env- 编辑
.env使用您的结构配置:
# Fabric configuration
FABRIC_AUTH_METHOD=browser
FABRIC_WORKSPACE_NAME=Your Workspace Name
FABRIC_LAKEHOUSE_NAME=Your Lakehouse Name
FABRIC_TABLES=customers,products,sales_transactions

# Optional: Service Principal (recommended for production)
# AZURE_TENANT_ID=your-tenant-id
# AZURE_CLIENT_ID=your-client-id
# AZURE_CLIENT_SECRET=your-client-secret- 安装依赖项:
pip install -r requirements.txt- 运行应用程序:
uvicorn app.main:app --host 0.0.0.0 --port 8000API将于 http://localhost:8000
- API文件:
http://localhost:8000/docs - 健康检查:
http://localhost:8000/health
数据生成器(可选——结构测试环境)
该存储库包括可选的辅助脚本, data_generator.py,它可以创建可用于测试查询和MCP交互的示例数据集。重要提示: data_generator.py 工作流旨在在Microsoft Fabric中的单独测试环境(沙盒或开发工作区)中运行——不要在生产环境中运行它。
使用说明:
- 生成器可以创建合成
customers,products,sales_transactions,以及web_analytics与此仓库中的示例兼容的数据集。 - 在单独的Fabric工作区或环境中部署或运行脚本,并拥有自己的lakehouse;配置
.env与目标FABRIC_WORKSPACE_NAME和FABRIC_LAKEHOUSE_NAME对于该测试环境。 - 生成器可能需要特定于结构的IAM权限才能写入目标湖屋;在测试工作区中使用具有写权限的服务主体或帐户。
示例(概念性):
# Run generator locally but pointed at a test Fabric workspace (configure .env first)
python data_generator.py --target-workspace "My Test Workspace" --lakehouse "TestLakehouse"
在测试lakehouse中创建数据后,更新您的主仓库 .env (或本地测试 .env)当您运行API或MCP服务器进行演示时,指向测试lakehouse表。
Docker部署
使用Docker Compose构建和运行:
docker-compose up --build或者手动构建并运行:
docker build -t duckdb-query-api .
docker run -p 8000:8000 --env-file .env duckdb-query-api
用法示例
健康检查
curl http://localhost:8000/health答复:
{
  "status": "ok"
}
简单查询
curl -X POST http://localhost:8000/query \
  -H "Content-Type: application/json" \
  -d '{
    "sql": "SELECT * FROM customers LIMIT 10"
  }'
聚合查询
curl -X POST http://localhost:8000/query \
  -H "Content-Type: application/json" \
  -d '{
    "sql": "SELECT COUNT(*) as total_customers FROM customers"
  }'
使用自定义行限制进行查询
curl -X POST http://localhost:8000/query \
  -H "Content-Type: application/json" \
  -d '{
    "sql": "SELECT * FROM products",
    "max_rows": 100
  }'
连接多个表
curl -X POST http://localhost:8000/query \
  -H "Content-Type: application/json" \
  -d '{
    "sql": "SELECT c.first_name, c.last_name, COUNT(t.transaction_id) as order_count FROM customers c LEFT JOIN sales_transactions t ON c.customer_id = t.customer_id GROUP BY c.customer_id, c.first_name, c.last_name"
  }'
身份验证方法
应用程序支持多种身份验证方法(通过配置 FABRIC_AUTH_METHOD):
1.服务负责人(生产-推荐)
设置所有三个环境变量:
AZURE_TENANT_ID=your-tenant-id
AZURE_CLIENT_ID=your-client-id
AZURE_CLIENT_SECRET=your-client-secret
2.交互式浏览器(默认)
FABRIC_AUTH_METHOD=browser打开浏览器窗口进行身份验证。
适用于Docker部署:运行 python get_token.py 首先在您的主机上生成一个缓存令牌,该令牌将被挂载到容器中。
3.Azure命令行界面
FABRIC_AUTH_METHOD=cli使用来自的凭据 az login.
4.默认凭证链
FABRIC_AUTH_METHOD=default使用Azure的DefaultAzureCredential(尝试多种方法)。
配置
所有配置均通过环境变量进行管理 .env:
| 变量 | 描述 | 默认值 |
|---|---|---|
APP_NAME | 应用程序名称 | DuckDB查询API |
API_PORT | 服务器端口 | 8000 |
DUCKDB_THREADS | DuckDB线程数 | 4 |
DUCKDB_MEMORY_LIMIT | 内存限制 | 1GB |
MAX_QUERY_TIMEOUT_SECONDS | 查询超时 | 30 |
MAX_RESULT_ROWS | 默认行限制 | 10000 |
LOG_LEVEL | 日志记录级别 | 信息 |
FABRIC_WORKSPACE_NAME | 结构工作区名称 | (必填) |
FABRIC_LAKEHOUSE_NAME | 织物湖屋名称 | (必填) |
FABRIC_TABLES | 逗号分隔的表列表 | (必填) |
安全功能
- 只读执行 -阻止INSERT、UPDATE、DELETE、DROP和其他写入操作
- SQL注入保护 -验证SQL语法和结构
- 查询超时 -防止长时间运行的查询阻塞资源
- 行限制 -可配置的最大结果集大小
- 非根容器 -Docker镜像以无特权用户身份运行
MCP支持
该项目包括一个模型上下文协议(MCP)服务器,使GitHub Copilot能够通过自然语言直接查询您的数据库。
快速设置:
- 启动FastAPI服务器(Docker或本地)
- 当Copilot需要时,MCP服务器会自动启动
- 在VS Code Chat中向Copilot询问有关数据的问题
示例查询:
- “按收入显示前10名客户”
- “有什么桌子?”
- “给我一份销售数据样本”
有关详细的设置说明和故障排除,请参阅 MCP_INTEGRATION.md.
API终点
GET /health
健康检查端点。
响应: 200 OK
{
  "status": "ok"
}
POST /query
执行只读SQL查询。
请求体:
{
  "sql": "SELECT * FROM table_name",
  "max_rows": 100  // Optional
}成功响应: 200 OK
{
  "columns": [
    {"name": "id", "type": "INTEGER"},
    {"name": "name", "type": "VARCHAR"}
  ],
  "rows": [
    {"id": 1, "name": "John"},
    {"id": 2, "name": "Jane"}
  ],
  "row_count": 2,
  "execution_ms": 12.34
}错误响应:
400-无效或非只读SQL422-验证错误504-查询超时500-内部服务器错误
发展
地方发展
# Create virtual environment
python -m venv venv
source venv/bin/activate  # On Windows: venv\Scripts\activate

# Install dependencies
pip install -r requirements.txt

# Run with auto-reload
uvicorn app.main:app --reload
代码质量
代码库遵循以下原则:
- 全程键入提示
- Pydantic v2用于验证
- 综合录井
- 清晰地分离关注点
- 在适当级别进行异常处理
故障排除
身份验证问题
如果遇到身份验证错误:
- 服务负责人:验证租户ID、客户端ID和客户端机密
- 对于Azure CLI:运行
az login并验证az account show - 用于交互式浏览器:确保您有浏览器访问权限和适当的权限
找不到表
确保表格:
- 列在
FABRIC_TABLES环境变量 - 存在于您的织物湖畔
- 可通过您的身份验证方法访问
查询超时
如果查询超时:
- 增加
MAX_QUERY_TIMEOUT_SECONDS - 优化SQL查询
- 考虑在Fabric中添加索引
MCP会话示例
图片在 doc/img/ 是模型上下文协议(MCP)会话的示例,演示了从MCP服务器到DuckDB的工作连接(通过Microsoft Fabric)。它们显示了代理发现表、采样行、运行计数/聚合查询以及返回表格结果。 MCP发现和湖屋中的可用表格(显示表格列表和摘要)。 对执行的示例行和总行数查询
web_analytics 桌子。 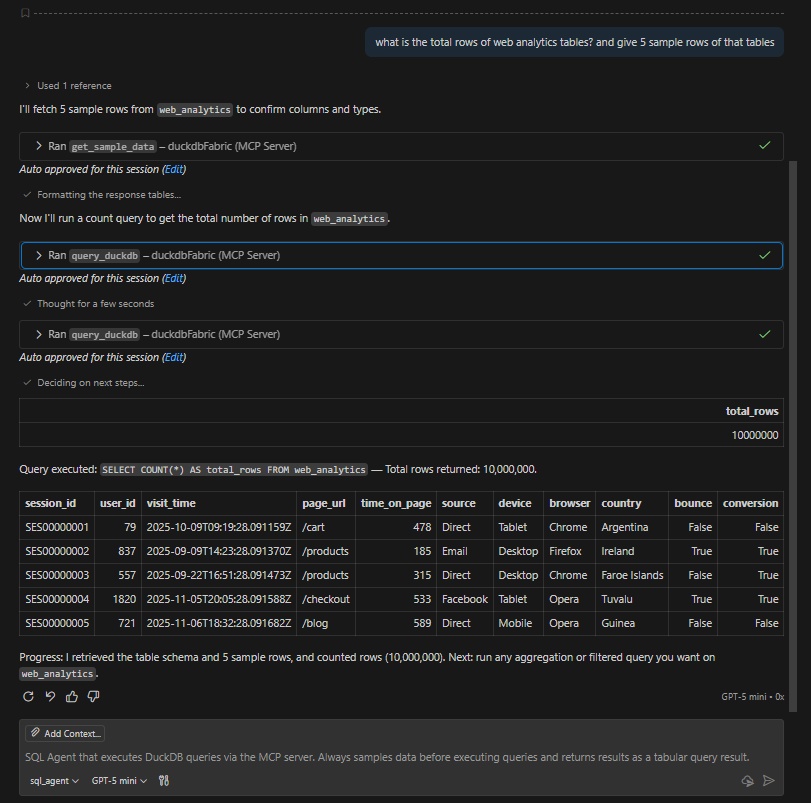 示例分析查询:本年度月度前5名购买产品。
这些截图是MCP服务器如何与DuckDB交互以及如何使用github copilot格式化结果的示例。
______________________________________________________________________
内置于:FastAPI、DuckDB和Azure SDK